Agent Readiness: jak měřit víc než zmínku firmy v AI
Návrh poctivého měření připravenosti na AI agenty: české úkoly, důkazy, opakování, bezpečné předání a obchodní výsledky bez vymyšleného univerzálního skóre.
Asistent zmíní váš e-shop, cituje správnou stránku, vybere jiné balení a zastaví se u košíku. Zvýšila se viditelnost? Možná. Byla nabídka použitelná pro konkrétní úkol zákazníka? Ne tak, jak zákazník potřeboval.
Agent Readiness je náš pracovní název pro hodnocení, zda agent firmu najde, správně pochopí nabídku a použije ji v povoleném úkolu. Jde o navrhovaný rámec. Ne o hotové skóre GEO Tracker AI, certifikaci nebo oficiální metriku OpenAI.
Po uvedení GPT-6.1 Sol a Dots potřebujeme tuto hranici pojmenovat. Schopnější nástroje a průběžná práce přidávají možnosti pomoci, ale také způsoby, jak správně znějící odpověď zakryje špatný výsledek. Důkaz musí sledovat cestu, ne pouze poslední odstavec.
- Oddělujte viditelnost odpovědi, správnost faktů, průchod úkolem a tržby.
- Úspěch a povolený bod zastavení stanovte před testem.
- Opakování ukáže proměnlivost. Malý pilot z něj ale nedělá reprezentativní výzkum.
- Český jazyk, lokální doprava a Kč musí být součást zadání, ne poznámka po testu.
- Nejdřív potřebujeme přehled důkazů a chyb. Jediné skóre může důležitý problém schovat.
Metodika a zdroje
Redakčně ověřeno k 2026-09-30.
Článek navrhuje pilotní protokol, nepopisuje dokončenou agentní studii. Počty v příkladu jsou hypotetické. Vycházíme z rozlišování AI odpovědí a obchodních výsledků a z doporučení OpenAI o omezených bězích a ověření výsledku computer use. Pro tento článek neproběhl nákup, přenos zákaznických dat ani produkční benchmark Dots.
Nový název potřebuje jasnou definici
Už dnes rozlišujeme zmínku, doporučení a citaci. Agent přidává kroky: otevření stránky, výběr varianty, přípravu porovnání nebo pokus o povolené předání. To nejsou zaměnitelná pozorování.
„Agent nás našel“ má znamenat zařazení do pozorovaného výběru a záznam cesty. „Pochopil nás“ vyžaduje porovnání získaných faktů s aktuální nabídkou. „Dokončil úkol“ potřebuje ověřený konečný stav, ne jen větu „hotovo“.
Ani správně dokončený úkol nedokládá obchodní přínos. Zákazník může výběr odmítnout nebo koupit jinde. Připravený košík není objednávka a formulář není zaplacená zakázka. Stejnou hranici vysvětlujeme u citací bez prokliku.
Smyslem nového rámce je přiřadit opravu ke skutečnému selhání. Ne spojit rozdílné události do působivého čísla.
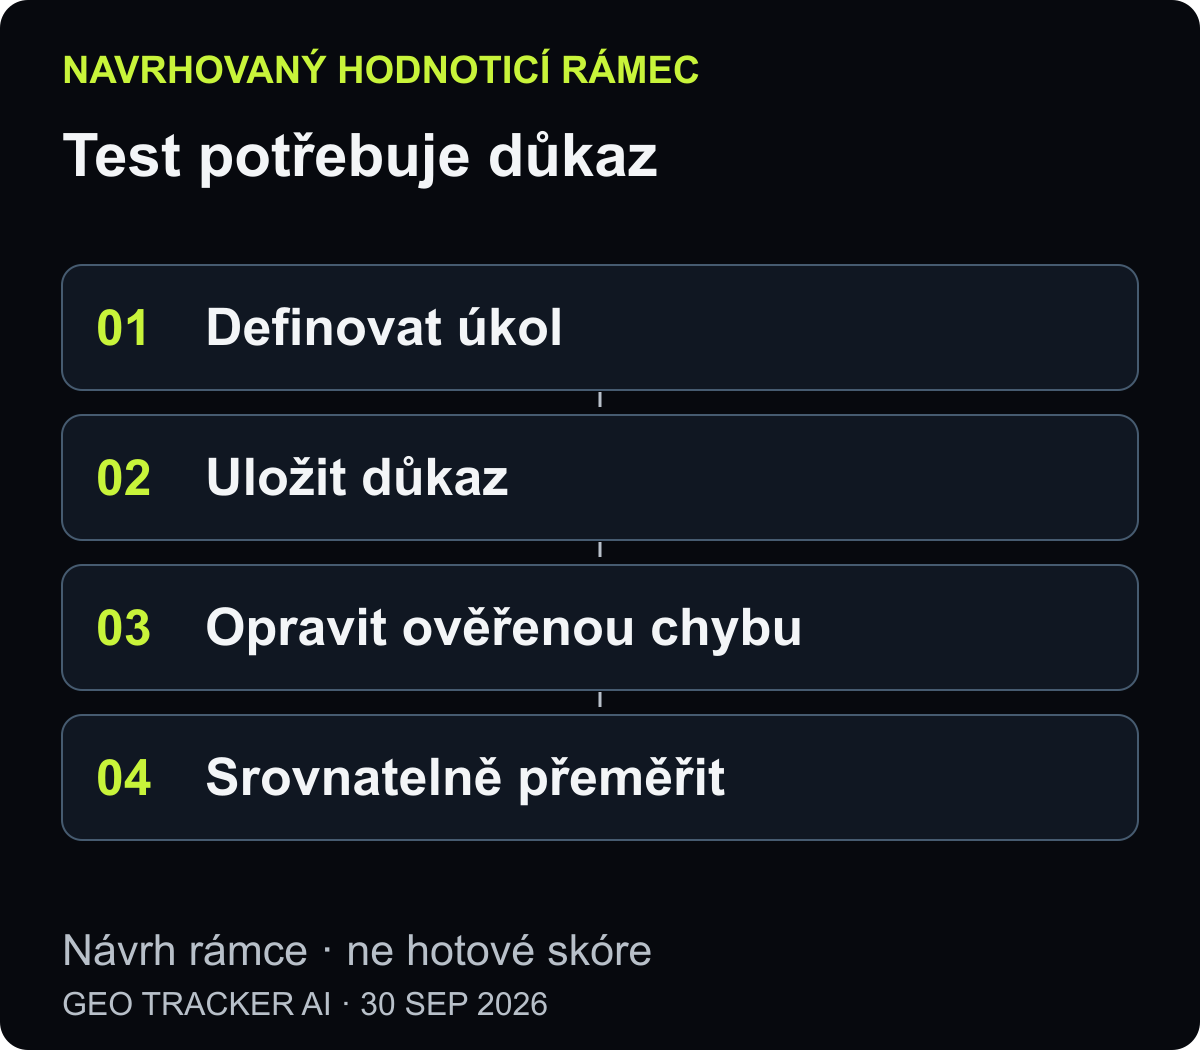
1. Sestavte úkoly podle zákazníků, ne podle značky
Začněte prací, kterou zákazník chce delegovat. Zařaďte nebrandované hledání, porovnání s podmínkami, ověření konkrétní nabídky a bezpečný další krok. Když v každém zadání uvedete vlastní značku, měříte rozpoznání na pokyn, ne samostatné nalezení.
U každého úkolu určete trh, jazyk, požadavky, potřebné údaje, přístup a očekávané zastavení. Přidejte i situaci, pro kterou nabídka není vhodná. Spolehlivý agent ji má vyřadit, ne se snažit za každou cenu vybrat vás.
Český příklad: „Najdi tři nabídky kompatibilního dílu do 2 000 Kč včetně známých nákladů na dopravu do Brna. Uveď neznámé podmínky. Připrav odkazy, nic nekupuj.“ Úspěchem je doložený výběr. Nejistá doprava se musí přiznat; vymyšlený termín není úspěch.
Panel musí zahrnout místní způsob nákupu: Kč, balení, region, adresu versus výdejní místo, B2B či spotřebitele a konkrétní podmínky. Český dotaz v americkém testovacím prostředí není automaticky česká zákaznická zkušenost. Zadání ověřte s obchodem a podporou; seznam vytvořený modelem sám nedokládá poptávku.
2. Předem stanovte, co se dá pozorovat
Místo nejasného „prošlo“ potřebujeme samostatná pole:
| Pozorování | Co je důkaz | Co nestačí |
|---|---|---|
| Zařazení firmy | Firma je ve viditelném pracovním výběru | Název pouze v dohledaném podkladu |
| Správnost údajů | Požadované údaje odpovídají aktuálním zdrojům | Plynulá odpověď a věrohodný odhad |
| Splnění podmínek | Agent správně uplatní požadavky a výluky | Doporučení navzdory chybějící nutné funkci |
| Povolené dokončení | Je ověřen předem určený konečný stav | Prohlášení o úspěchu bez výsledku |
| Správné předání | Agent přizná chybějící údaj nebo vyžádá souhlas | Domyšlení faktu či přeskočení schválení |
Ne každá položka patří ke každému úkolu. Průzkum nemusí obsahovat formulář. Takové pole označte jako nerelevantní, ne nulou. Výpadek služby zase může znamenat neměřeno nebo provozní chybu, nikoli špatný výkon značky.
Připravte příklad správného a nesprávného výsledku ještě před během. Pokud se dva hodnotitelé neshodnou, co znamená „vhodná nabídka“, musíte nejdřív vyřešit kritérium. Jinak další čísla pouze zakryjí rozdílné názory.
3. Zachovejte kontext a důkaz běhu
Zaznamenejte službu a rozhraní, zveřejněný model, nástroje, datum, jazyk, zemi, stav relace, verzi úkolu a povolené akce. API s vybranými nástroji není totéž co běžná odpověď ChatGPT ani Dot s pamětí a připojenými aplikacemi.
Předchozí konverzace a paměť mohou výběr ovlivnit. Pokud lze, použijte popsaný postup nové relace. Pokud ne, uveďte trvalý kontext jako součást testu. Stejná slova automaticky neznamenají nezávislá opakování.
Uložte navštívené zdroje, získané údaje, stav rozhraní, chyby a konečný bod. Do veřejného reportu nepatří přihlašovací údaje, soukromé účty ani osobní data zákazníka. Publikovaná studie má vysvětlit zjištění v anonymizované podobě, ne odhalit celou relaci.
Určete limit kroků, času a nákladů i způsob ukončení. Dokumentace computer use zdůrazňuje omezené běhy a ověření skutečného výsledku. Bez těchto hranic se testování může změnit v nechtěnou akci.
4. Opakujte, ale nevyrábějte statistickou jistotu
Jeden úspěšný běh dokládá možnost. Nedokládá spolehlivost pro všechny zákazníky, úkoly a období. Opakování vybraných scénářů může ukázat jiný výběr, přehlédnuté podmínky nebo občasnou chybu.
Neexistuje univerzální důkaz, že tři běhy stačí pro všechny agenty. Naše metodika týdenního měření odpovědí popisuje současný monitoring, nikoli optimální počet opakování jakéhokoli agentního úkolu. Pilot musí velikost vzorku přiznat a přizpůsobit ji riziku, nákladům a pozorované proměnlivosti.
Hypotetický příklad: deset úkolů po třech bězích vytvoří 30 pozorování. Pokud 18 dosáhne určeného bezpečného cíle, pozorovaný podíl je 18/30, tedy 60 %, v daném panelu a prostředí. Není to 60% pravděpodobnost nákupu u českých zákazníků. Pokud tři běhy zablokoval výpadek služby, uveďte je zvlášť a pojmenujte jmenovatele. Potichu je nevyřazujte.
Jednoduché dohledání ceny nesčítejte do nevysvětleného průměru se složitým porovnáním více webů. Ukazujte počty podle typu úkolu a rozsah, který panel skutečně pokrývá.
5. Nejdřív určete příčinu, teprve pak viníka
Chybný výsledek může způsobit rozpor na webu, špatná interakce, nepochopení správných informací modelem nebo timeout nástroje. Správné vyžádání souhlasu zase může úkol záměrně zastavit.
Navrhujeme oddělit chybu dat nabídky, chybu rozhraní, interpretaci agenta, přístup či výpadek platformy a správné bezpečnostní předání. Nejistou příčinu označte. „Příčina zatím není potvrzená“ je hodnotnější než nepodložené „SEO vám nefunguje“.
Před zadáním změny problém reprodukujte. Člověk ověří, zda požadavek na stránce opravdu chybí. Další běh může ukázat, zda se agentní chyba opakuje. Ani jedno automaticky nevysvětlí vnitřní důvod, proč poskytovatel vybral konkurenci.
Výstupem má být karta důkazu: úkol, zdroj, obchodní riziko, pravděpodobná příčina a míra jistoty, vlastník a test po opravě. U české spolupráce zachováváme odpovědnost: GEO Tracker AI diagnózu, priority a zadání připravuje, váš tým nebo agentura změny realizuje.
6. Přeměřujte bez ztráty srovnatelnosti
Pokud lze, ponechte úkol a podmínky. Zaznamenejte nasazenou změnu a datum, kdy byla veřejně dostupná. Změna modelu, agentního produktu, nástrojů nebo přístupu patří vedle výsledku, ne pod čáru.
Po významném releasu může být správné vytvořit novou baseline. Srovnání starého a nového prostředí nad stejnými úkoly může pomoci oddělit opravu webu od změny platformy, pokud to přístup a náklady dovolí. Bez této kontroly popište změnu, ale netvrďte silnou příčinnou souvislost.
Tržby zůstávají samostatná otázka. Ověřujte poptávky, objednávky a zpětnou vazbu ve vlastních datech. Návštěva připomínající bota sama neurčuje nákupního agenta ani atribuci zakázky.
Proč bychom nezačínali jedním skóre
Souhrnné skóre potřebuje obhajitelné váhy, pravidla pokrytí a zacházení s neznámými výsledky. Stejné váhy pěti oblastí jsou volba návrhu, ne vědecký objev. Web s přesnými fakty a nefunkčním předáním nemá kritickou závadu schovat za průměr.
První hodnotný výstup je profil: které úkoly se měřily, kolik běhů bylo použitelné, co bylo správně, kde se cesta zastavila a co opravíme. Skóre má smysl až tehdy, když rozhodování zpřehlední a jeho definice obstojí při kontrole.
Tímto článkem oznamujeme směr uvažování a návrh pilotu, nikoli zapnuté měření Dots v GEO Tracker AI. Český vedený program dál pracuje se současným měřením odpovědí. Nová vrstva potřebuje vlastní ověřený přístup, protokol, nákladové hranice a důkazy před tím, než ji nabídneme jako hotovou.
Takovou transparentnost požadujte od každého, kdo prodává „Agent Readiness“: ukažte úkol, důkaz, hranice a další opravu. Samotný název nedokazuje nic.
Časté dotazy
Stejné otázky a odpovědi posíláme i jako strukturovaná data (FAQPage), aby je AI enginy mohly citovat doslovně.
- Je Agent Readiness oficiální standard nebo certifikace?
- Ne. V tomto článku jde o navrhovaný rámec GEO Tracker AI pro hodnocení konkrétních úkolů. Není to standard OpenAI ani nově zapnuté produktové skóre. Před závěry je nutné určit panel, hodnoticí kritéria, podmínky běhu, důkazy a hranice.
- Dokazují tři agentní běhy spolehlivost?
- Univerzálně ne. Opakování může odhalit proměnlivost, ale malý panel nereprezentuje všechny zákazníky a prostředí. Počet běhů volte podle rizika, nákladů a pozorovaného chování. Uveďte velikost vzorku, skutečné podmínky a neznámé výsledky.
- Jak hodnotit blokovaný nebo nedostupný běh?
- Zachovejte jeho stav a důvod. Nerelevantní pole, neměřený výsledek, výpadek platformy a správné bezpečnostní předání nejsou totéž. Každá metrika potřebuje jasný jmenovatel. Incidenty potichu nevyřazujte a chybějící důkaz nepřevádějte na potvrzený neúspěch firmy.
- Dokládá dokončený úkol růst tržeb díky GEO?
- Ne. Ověřený výběr, košík nebo poptávka jsou výsledky úkolu, ne prodej ani příčinná atribuce. Kvalifikované poptávky, objednávky a zpětnou vazbu ověřujte zvlášť ve vlastních datech. Srovnání před a po musí zachovat kontext změn webu, modelu a nástrojů.
Metodika a navazující zdroje
- OpenAI: Computer use — omezení běhu a kontrola výsledku.
- OpenAI: Bezpečnost Dots — přístup, schvalování a zbývající rizika.
- Naše metodika opakovaných odpovědí — současný monitoring, ne univerzální agentní benchmark.
- Interpretace výzkumu nákupních odpovědí — význam rozhraní a opakování.
Ověřeno 30. září 2026. Panel, hodnoticí pole a příklad s počty jsou návrh, nikoli naměřené výsledky.
Související články
Vaše GEO Score
Vytvořte si obhajitelný základ viditelnosti v AI
Použijte opakované kontroly podporovaných enginů, abyste viděli, zda se značka objevuje, v jakém kontextu a jak se výsledek mění v čase.